이 글은 LLM 추론 칩 검증 이야기 시리즈의 1편입니다. 1편에서는 검증의 “정답"이 어디서 오는지 다룹니다. 2편에서는 느린 시뮬레이션의 한계를 에뮬레이터로 넘는 방법과, 언제 검증이 끝났다고 말할 수 있는지 다룹니다.
들어가며
안녕하세요, HyperAccel DV팀 장유전입니다. 이 글에서는 HyperAccel의 실제 검증 흐름을 예로 들어, Large Language Model(LLM) 추론 칩을 검증할 때 “정답"을 어떻게 정하는지 이야기해 보려고 합니다.
먼저 질문 하나로 시작해 보겠습니다. 같은 AI 모델을 GPU에서 돌린 답과 LLM Processing Unit(LPU) 의 RTL에서 돌린 답이 다를 때, 과연 누가 틀린 걸까요?
동일한 AI 모델을 올린 GPU와 LPU의 RTL에 같은 프롬프트와 같은 설정값을 넣었다고 해 보겠습니다. 수십 개의 토큰이 똑같이 나오다가 어느 한 자리에서 다른 토큰이 나왔다면, LPU가 틀린 걸까요, 아니면 GPU 쪽이 틀린 걸까요? 어쩌면 둘 다 맞은 것일 수도 있습니다.
소프트웨어 버그라면 코드를 고쳐서 다시 배포하면 되지만, 칩은 사정이 다릅니다. 한 번 제조한 칩의 회로는 바꿀 수 없기 때문에, 버그를 고치려면 설계를 수정해 칩을 다시 찍어야 하고 여기에는 몇 달의 시간과 큰 비용이 듭니다. 그래서 칩은 제조 전에 설계가 맞는지 최대한 확인해야 하는데, 이 일을 검증(verification) 이라고 합니다.
검증이라고 하면 테스트벤치 언어나 Universal Verification Methodology(UVM) 같은 도구를 먼저 떠올리기 쉽습니다. 하지만 이 글에서는 도구보다 더 근본적인 질문을 다루려고 합니다. 무엇과 비교해야 “맞다"고 말할 수 있을까요? 다시 말해, 칩의 정답 은 어디서 오는 걸까요?
이 글의 핵심은 두 가지입니다.
- 정답은 하나가 아니라, 검증 레벨마다 정답의 출처가 다릅니다.
- 각 비교 축은 되도록 한 가지만 다르게 하기 때문에, 어느 비교에서 불일치가 났는지만 봐도 누구의 문제인지 알 수 있습니다.
검증은 결국 비교입니다
본격적으로 들어가기 전에, 이 글에서 쓰는 용어를 먼저 정리하겠습니다.
- Register Transfer Level(RTL): 디지털 회로의 동작을 레지스터 간 데이터 전달과 연산 중심으로 표현하는 설계 수준입니다. 일반적으로 Verilog나 SystemVerilog 같은 하드웨어 기술 언어로 작성하고, Synopsys VCS 같은 시뮬레이터로 설계의 기능과 동작을 검증합니다. 이 수준으로 작성한 설계 코드를 RTL 코드라고 하며, 이 글에서는 줄여서 RTL이라고 부릅니다.
- IP와 Top: Intellectual Property(IP)는 특정 기능을 맡는 회로 설계 단위로, 반도체 업계에서는 이렇게 독립적으로 설계하고 재사용할 수 있는 단위를 IP라고 부릅니다. 칩은 여러 IP를 연결해 만들며, IP 레벨 검증은 IP 하나를 떼어 확인하고, Top 레벨 검증은 IP를 모두 연결한 칩 전체를 확인합니다.
- 레퍼런스 모델: RTL과 같은 입력을 받아 기대값을 계산하는 소프트웨어로, RTL의 출력이 이 기대값과 같은지 비교하는 데 씁니다.
- functional simulator(fsim): 칩의 아키텍처를 기능적 수준에서 모사한 시뮬레이터입니다. 명령어 수준의 정확도를 빠르게 검증하고, 소프트웨어 스택을 개발하는 데 사용됩니다.
- bit-exact: 두 결과가 비트 하나까지 완전히 같다는 뜻으로, 오차를 조금도 허용하지 않습니다.
- 허용오차(tolerance): 두 결과의 차이가 정해진 범위 안에 있으면 같은 것으로 보는 비교 기준입니다. 이 차이는 구현이 틀려서가 아니라, 부동소수점 덧셈의 순서나 숫자의 정밀도처럼 계산 방식이 달라서 생깁니다. 같은 모델을 CPU와 GPU에서 돌려도 결과가 조금씩 다른 것이 대표적인 예입니다.
검증은 결국 같은 입력을 두 구현에 넣고 출력을 비교하는 일입니다. 둘이 다르면 어딘가에 문제가 있다는 뜻이지만, 무엇과 비교하느냐에 따라 찾을 수 있는 문제는 달라집니다.
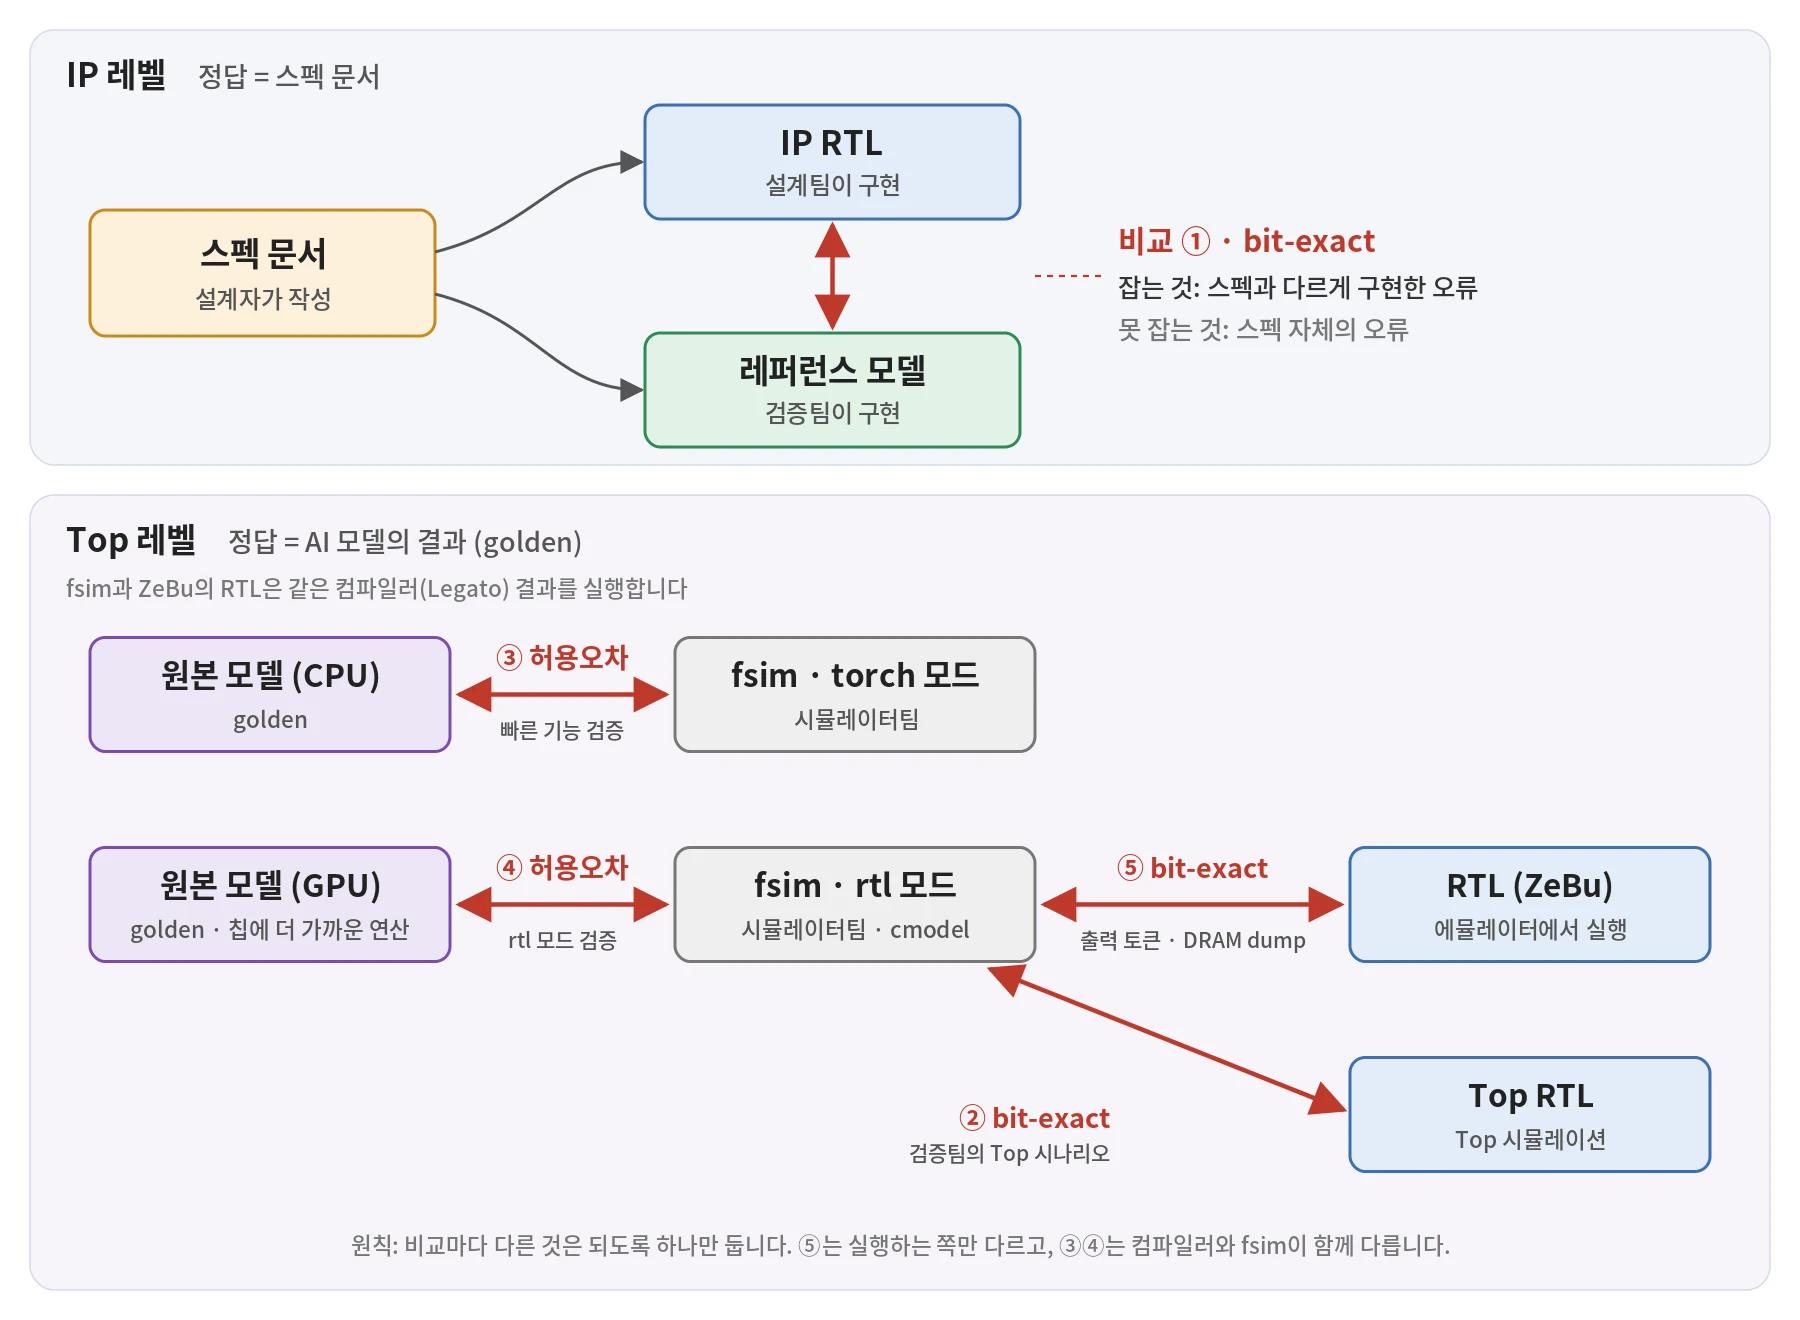
아래 표는 이 글에서 다룰 비교 축 전체입니다.
| # | 비교 | 기준 | 잡아내는 것 |
|---|---|---|---|
| ① | IP RTL ↔ 레퍼런스 모델 | bit-exact | 스펙과 다르게 구현한 오류 |
| ② | Top RTL ↔ fsim(rtl) | bit-exact | IP 간 통합 오류, 스펙 해석 차이 |
| ③ | fsim(torch) ↔ golden(CPU) | 허용오차 | 스펙·알고리즘 오류, 컴파일러 오류 |
| ④ | fsim(rtl) ↔ golden(GPU) | 허용오차 | rtl 모드의 오류, 스펙·알고리즘 오류 |
| ⑤ | RTL(ZeBu) ↔ fsim(rtl) | bit-exact | rtl 모드와 RTL의 차이, RTL 자체의 오류 |
여기서 중요한 원칙이 하나 있습니다. 각 비교 축은 되도록 한 가지만 다르게 합니다.
소프트웨어 엔지니어라면 커밋 범위를 반씩 좁혀 버그를 만든 커밋을 찾는 git bisect 를 떠올리면 쉽습니다.
비교 축도 비슷하게 동작해서, 두 구현 사이에 다른 점이 하나뿐이면 불일치의 원인도 그 하나로 좁혀집니다.
그래서 어느 비교 축에서 어긋났는지만 보면 누구의 문제인지 알 수 있습니다.
다만 현실에서는 이 원칙을 지키기 어려운 비교 축도 있는데, 실제 모델을 돌리는 단계에서 그런 예를 보겠습니다.
IP 레벨(①): 스펙 문서가 정답입니다
IP 레벨에서 정답은 스펙 문서 이고, 더 정확히는 검증자가 스펙 문서만 보고 따로 만든 레퍼런스 모델입니다.
HyperAccel은 RTL 설계와 검증을 서로 독립된 팀이 맡습니다. IP 레벨 레퍼런스 모델은 검증자가 RTL 스펙 정의 문서를 기준으로 만들며, RTL을 보고 만들지는 않습니다.
왜 이렇게 번거롭게 할까요? 같은 사람이 같은 생각으로 두 번 구현하면 같은 실수를 반복하기 쉽고, 두 구현이 같은 실수를 공유하면 결과는 완벽히 일치합니다. 그러면 버그는 아무 경고 없이 통과하기 때문에, 레퍼런스 모델은 RTL과 독립적으로 만들어져야 의미가 있습니다.
IP 레벨에서는 RTL과 레퍼런스 모델을 bit-exact로 비교합니다. 같은 스펙을 보고 만든 두 구현이니, 마지막 비트까지 같아야 하기 때문입니다.
IP 레퍼런스 모델을 PyTorch와 비교하지는 않습니다. IP 레벨의 정답은 스펙 하나뿐이고, AI 모델과의 비교는 Top 레벨의 몫이기 때문입니다.
팀이 나뉘어도 독립성이 깨지는 경우
팀을 나눴다고 독립성이 저절로 생기지는 않습니다. 일반적으로 다음 세 가지 경우에는 팀이 달라도 같은 오류를 공유하게 됩니다.
- 설계자의 모델을 그대로 쓰는 경우: 설계자가 만든 모델을 검증팀이 레퍼런스로 가져다 씁니다.
- 모호한 스펙을 설계자에게 묻는 경우: 스펙이 애매한 부분을 설계자에게 묻고, 그 답대로 테스트벤치를 만듭니다.
- RTL을 읽고 기대값을 만드는 경우: 스펙 대신 RTL을 보고 기대값을 계산합니다.
세 경우 모두 설계자의 해석이 검증 쪽으로 흘러 들어가기 때문에, 두 구현은 더 이상 독립적이지 않습니다.
HyperAccel의 구조는 첫째와 셋째 경우를 피합니다. 레퍼런스 모델은 검증자가 직접 만들고, 그 기준은 RTL이 아니라 스펙 문서입니다.
둘째 경우는 스펙 문서를 설계자가 쓰기 때문에 완전히 피하기 어렵습니다. 검증자는 검증하면서 모호한 부분을 찾아 설계자에게 질문하고, 설계자는 그 부분을 해석해 스펙 문서를 수정합니다.
여기서 중요한 점은 답이 스펙 문서 에 남는다는 것입니다. 검증자가 들은 답을 테스트벤치에만 반영하지 않고, 수정된 문서가 다시 설계와 검증 모두의 기준이 됩니다. 정답의 출처가 문서 하나로 유지되는 셈입니다.
그래도 해석 자체는 설계자의 것이어서, 그 해석이 틀렸다면 RTL과 레퍼런스 모델이 함께 틀립니다. 이 한계를 이어서 살펴보겠습니다.
한계: 스펙이 틀리면 둘 다 똑같이 틀린다
IP 레벨 구조에는 분명한 한계가 있습니다. 설계자와 검증자가 같은 스펙 문서 를 보고, 그 문서는 설계자가 쓰기 때문입니다.
스펙 문서 자체가 틀렸다면 어떻게 될까요? 설계자는 틀린 스펙대로 RTL을 만들고, 검증자도 틀린 스펙대로 레퍼런스 모델을 만듭니다. 두 결과는 똑같이 틀리기 때문에 오히려 완벽히 일치합니다.
IP 레벨 검증이 증명하는 것은 “RTL이 스펙대로 만들어졌다"이지, “스펙이 옳다"가 아닙니다. 스펙이 옳은지 확인하려면 스펙 문서를 거치지 않는 정답이 필요하고, 그 정답이 Top 레벨에 있습니다.
Top 레벨: AI 모델의 결과가 정답입니다
Top 레벨에서는 IP를 모두 연결한 칩 전체를 검증하며, 여기서 정답은 스펙 문서가 아니라 실제 AI 모델의 결과 입니다.
AI 모델은 스펙 문서를 보고 만든 것이 아니기 때문에, 이 정답은 스펙 문서와 출처가 다릅니다. 그래서 IP 레벨이 놓친 스펙 자체의 오류가 여기서 드러납니다.
Transformer World에서 attention 연산을 소개했는데, 그 연산이 칩 위에서도 같은 값으로 나오는지 확인하는 곳이 바로 Top 레벨입니다.
golden, fsim, 그리고 컴파일러
Top 레벨의 정답은 Hugging Face에 공개된 원본 모델을 PyTorch로 실행한 결과입니다. 하드웨어도 컴파일러도 거치지 않은 가장 바깥의 정답으로, 검증에서는 이런 기준 결과를 golden 이라고 부릅니다.
다만 golden과 RTL을 곧바로 비교하지는 않습니다. RTL 시뮬레이션은 LLM 전체를 돌리기에는 너무 느리고, 칩이 나오기 전에는 컴파일러를 시험해 볼 곳도 없습니다. 그래서 칩의 동작을 소프트웨어로 흉내 내는 fsim을 두는데, fsim은 golden과 RTL 사이의 큰 간격을 두 단계로 나눠 어긋났을 때 원인을 좁히는 역할도 합니다.
fsim은 설계팀도 검증팀도 아닌 또 다른 팀인 시뮬레이터팀이 만듭니다. 시뮬레이터팀도 검증팀과 마찬가지로 스펙 문서를 보고 fsim을 만들기 때문에, 같은 스펙에서 출발한 독립된 구현이 하나 더 있는 셈입니다.
fsim은 IP 레퍼런스 모델을 이어 붙여 만든 것이 아니라, 완전히 별개의 모델입니다. 그래서 IP 레퍼런스 모델에 실수가 있더라도, 그 실수가 Top 레벨의 비교로 그대로 옮겨 가지 않습니다.
fsim에는 torch 모드와 rtl 모드, 두 가지 모드가 있습니다. torch 모드는 빠른 디버깅과 기능 검증에 쓰고, rtl 모드는 칩의 동작을 그대로 따라가는 C 모델(cmodel)로 RTL과 비트 단위까지 같은 결과를 내는 것을 목표로 합니다.
AI 모델을 칩에서 돌리려면 컴파일러가 모델을 칩이 실행할 프로그램으로 바꿔야 합니다. 이 일은 HyperAccel의 자체 컴파일러인 Legato가 맡고, fsim과 ZeBu의 RTL은 모두 Legato가 만든 프로그램을 실행합니다.
Top 시뮬레이션(②): 값이 fsim과 똑같은가
검증팀은 AI 모델을 돌리기 전에, UVM으로 만든 빠른 Top 테스트로 IP 사이의 연결부터 확인합니다. 이 이야기는 2편에서 자세히 다루고, 여기서는 값을 비교하는 테스트를 보겠습니다.
IP 하나씩 볼 때는 드러나지 않던 통합 오류가 IP를 연결하면 값의 차이로 나타납니다. 이때 쓰는 Top 시나리오도 검증팀이 구성하며, 기대값은 rtl 모드 fsim에서 나옵니다. Top RTL과 rtl 모드 fsim은 bit-exact로 비교합니다(표의 ②).
이 비교가 잡는 것과 못 잡는 것은 분명합니다. Top RTL과 fsim은 서로 다른 팀이 같은 스펙 문서를 보고 만들었기 때문에, 둘이 다르면 같은 스펙을 서로 다르게 해석한 곳이 드러납니다. 반대로 스펙 자체가 틀렸다면 둘은 똑같이 틀리고 이 비교를 통과하므로, 스펙 오류를 잡으려면 스펙을 거치지 않는 golden과 비교해야 합니다.
실제 모델로 쌓는 세 단계
실제 AI 모델을 돌리는 검증은 세 단계로 쌓아 올립니다. fsim과 컴파일러를 각자 개발한 뒤, 둘을 하나의 환경에서 함께 돌리며 시작합니다.
1단계(③): torch 모드와 CPU golden, 기능부터 빠르게
먼저 torch 모드 fsim으로 컴파일러 결과를 실행하고, 원본 모델을 CPU에서 돌린 golden과 비교합니다. 약간의 오차를 허용하며, 허용 범위는 같은 연산을 CPU와 GPU에서 돌렸을 때 생기는 차이 정도입니다. 빠르게 돌려 보며 기능이 맞는지부터 확인하는 단계입니다.
2단계(④): rtl 모드와 GPU golden, 칩에 더 가깝게
이번에는 rtl 모드 fsim으로 컴파일러 결과를 실행하고, 원본 모델을 GPU에서 돌린 golden과 비교합니다. GPU는 CPU보다 정밀도와 연산 방식이 칩에 더 가깝기 때문에, 더 정확하게 디버깅할 수 있고 rtl 모드 자체도 함께 검증됩니다. 이 비교도 약간의 오차를 허용합니다.
3단계(⑤): ZeBu의 RTL과 rtl 모드, 비트까지 똑같이
마지막으로 같은 컴파일러 결과를 실제 RTL에서 실행하는데, RTL은 Synopsys의 에뮬레이터인 ZeBu 위에서 돌립니다. 에뮬레이터는 RTL을 전용 하드웨어에 올려 시뮬레이터보다 훨씬 빠르게 실행하는 장비이며, 자세한 이야기는 2편에서 다룹니다.
이 단계에서는 rtl 모드 fsim과 ZeBu의 결과를 bit-exact로 비교하는데, 출력 토큰뿐 아니라 DRAM에 남은 데이터(DRAM dump)까지 비교합니다. 이를 통해 rtl 모드 fsim과 실제 RTL이 완전히 같은 결과를 내는지, RTL 자체에 문제는 없는지 확인합니다.
정답은 한 단계씩 이어진다
세 단계를 “한 가지만 다르게” 원칙으로 다시 보면 흥미로운 점이 보입니다.
3단계(⑤)는 원칙이 가장 잘 지켜지는 비교 축입니다. 양쪽 모두 같은 컴파일러 결과를 실행하고 실행하는 쪽만 fsim에서 RTL로 바뀌기 때문에, 불일치가 나면 원인은 rtl 모드 fsim과 RTL 사이로 좁혀집니다.
반대로 1, 2단계(③, ④)는 원칙에서 벗어납니다. golden과 비교하면 컴파일러와 fsim, 두 가지가 함께 다르기 때문에, 불일치가 나도 이 비교만으로는 어느 쪽이 틀렸는지 알 수 없습니다.
그래서 이 단계에서는 golden을 기준으로 분석해 어느 쪽이 틀렸는지 판단합니다. 최종 출력만 보지 않고 레이어별 중간 결과까지 golden과 맞춰 보며, 어느 레이어에서 처음 어긋나는지를 찾아 원인을 좁힙니다. 원칙을 지키지 못한 비교 축에는 이런 분석 비용이 따른다는 점에서, 비교 축을 나누는 원칙이 왜 중요한지 거꾸로 보여 주는 예입니다.
정리하면 정답은 한 단계씩 이어집니다. golden이 fsim의 정답이 되고, rtl 모드 fsim은 다시 RTL의 정답이 됩니다.
이 역할 분담은 CPU 검증과 비슷합니다. 일반적으로 CPU 검증자는 각 명령어가 스펙대로 동작하는지 확인하고, 그 명령어로 만든 프로그램의 결과는 컴파일러와 소프트웨어가 책임집니다. 칩 검증도 마찬가지로, 칩이 스펙대로 동작하는지는 RTL과 fsim의 bit-exact 비교가, 모델이 제대로 돌아가는지는 컴파일러를 거친 golden과의 비교가 맡습니다.
허용오차는 꼭 필요한 곳에만 둡니다
앞의 비교 표에서 기준 칸을 다시 보면, RTL이 직접 걸린 비교는 모두 bit-exact입니다. 오차를 허용하는 것은 fsim을 golden과 비교하는 두 곳(③, ④)뿐인데, fsim과 golden은 둘 다 맞으면서도 마지막 비트가 다를 수 있기 때문입니다. 용어 정리에서 본 것처럼, PyTorch조차 CPU와 GPU에서 결과가 미세하게 다릅니다.
오차를 허용하면 비교가 가능해지지만, 대신 대가가 있습니다. 허용오차는 작은 버그를 숨길 수 있습니다.
가상의 예를 들어, 컴파일러가 특정 연산에서만 반올림 방식을 잘못 고른다고 해 봅시다. 이 오류는 결과의 마지막 비트 몇 개만 바꾸기 때문에, 그 차이가 CPU와 GPU의 차이 정도라면 허용오차 안에 들어가 ③과 ④를 통과할 수 있습니다.
그래서 허용오차는 꼭 필요한 곳에만 두고, 비교마다 맡은 역할에 맞춰 기준을 정합니다. golden과의 비교는 스펙을 거치지 않은 정답과 맞춰 보기 때문에 스펙 자체의 오류를 잡아내고, 계산 방식 차이로 생기는 작은 오차는 허용해도 이 역할을 해낼 수 있습니다. 반면 RTL을 비교하는 축은 같은 입력에 대한 두 구현의 결과를 맞춰 보며 구현 사이의 차이를 잡아내는 것이 역할이라, 모두 bit-exact로 비교합니다. 허용오차가 없는 곳에서는 비트 하나의 차이도 숨을 곳이 없습니다.
마치며: 어디서 어긋나면 누구를 의심할까
처음 질문으로 돌아가 보겠습니다. 같은 AI 모델을 GPU에서 돌린 답과 LPU의 RTL에서 돌린 답이 다를 때, 누가 틀린 걸까요?
답은 어느 비교 축에서 불일치가 났는지에 달려 있습니다.
- IP RTL과 레퍼런스 모델이 다르면, 스펙과 다르게 구현한 것입니다.
- Top 시뮬레이션에서 Top RTL과 fsim이 다르면, IP 사이의 통합이나 스펙 해석을 의심합니다.
- fsim과 golden이 다르면, 스펙·알고리즘, 컴파일러, fsim을 의심하고 레이어별로 따져 가립니다.
- ZeBu의 RTL과 rtl 모드 fsim이 다르면, RTL이나 rtl 모드 fsim을 의심합니다.
이런 판단이 가능한 이유는 정답의 출처를 레벨마다 나눴고, 각 비교 축에서 다른 것을 되도록 하나로 줄였기 때문입니다. 칩을 다시 찍지 않기 위한 검증의 뼈대가 바로 이 구조입니다.
이 원칙은 칩 검증에만 해당하지 않습니다. 모델을 다른 프레임워크로 옮기거나, 양자화하거나, 새 하드웨어로 이식할 때도 같은 질문이 생깁니다. 무엇이 정답인지 먼저 정하고 한 번에 한 가지만 바꿔 비교하면, 결과가 어긋났을 때 어디를 봐야 할지 알 수 있습니다.
다만 Top 시뮬레이션은 느려서, 긴 LLM 워크로드를 끝까지 돌리기에는 시간이 너무 오래 걸립니다. 2편에서는 이 한계를 에뮬레이터로 어떻게 넘는지, 그리고 언제 “검증이 끝났다"고 말할 수 있는지 이야기하겠습니다.
추신: HyperAccel은 채용 중입니다!
칩을 다시 찍지 않으려면, 누군가는 끝까지 “정말 맞는가"를 물어야 합니다. HyperAccel에서는 설계, 검증, 시뮬레이터, 컴파일러 팀이 각자의 정답을 들고 같은 칩을 들여다봅니다. 정답의 출처를 따지고 비교 축을 설계하는 일에 흥미가 있으시다면, 언제든지 지원해 주세요!