LLM & 모델
Project Glasswing: Claude Mythos Preview
Anthropic의 Project Glasswing과 Claude Mythos Preview를 중심으로, 모델의 사이버보안 역량이 왜 도약했는지, 벤치마크가 어떻게 바뀌었는지, 실제 방어 사례를 정 …
HYPERACCEL TECH BLOG
칩 설계, 메모리, 컴파일러, 인프라, 모델까지. HyperAccel 엔지니어들이 AI 스택 전 층위에서 배운 것을 기록합니다.
레이어를 누르면 분야별 글이 아래로 펼쳐집니다
L5 · Model
Transformer 구조, 서빙 프레임워크, 최신 모델 분석을 다룹니다.
LLM & 모델
Anthropic의 Project Glasswing과 Claude Mythos Preview를 중심으로, 모델의 사이버보안 역량이 왜 도약했는지, 벤치마크가 어떻게 바뀌었는지, 실제 방어 사례를 정 …
LLM & 모델
Transformer 기반 LLM의 내부 구조를 하나하나 뜯어보며, 각 모듈이 갖는 의미와 최적화 기법까지 정리합니다.
LLM & 모델
SGLang의 철학 LLM이 도입된 이후, LLM은 문제 해결, 코드 작성, 질문 답변 등 다양한 분야에서 복잡한 작업을 해결하는 데 사용되어 왔습니다. 오늘날 LLM은 에이전트 능력을 확장하여 인 …
L4 · Infra
Kubernetes 기반 개발 환경, CI/CD, 디바이스 플러그인 등 HyperAccel의 인프라 구축기입니다.
인프라 & DevOpsK8s 개발 환경 구축기 - Part 03
안녕하세요! 저는 HyperAccel ML팀에서 DevOps Engineer로 근무하고 있는 전영훈입니다. 이번 포스팅은 Kubernetes 기반 사내 개발 환경 구축기 시리즈의 3번째 글입니다! …
인프라 & DevOpsK8s 개발 환경 구축기 - Part 02
HyperAccel의 CI/CD 인프라를 Actions Runner Controller(ARC) 기반으로 전면 재설계한 기술적 여정과 Vault JWT/Kubernetes Auth 이중 연동, 그리 …
인프라 & DevOpsK8s 개발 환경 구축기 - Part 01
안녕하세요! 저는 HyperAccel ML팀에서 DevOps Engineer로 근무하고 있는 전영훈입니다. 이 글을 보시는 분들 중에서 개발자 여러분들은 어떤 환경에서 개발하고 계신가요? 로컬 환경 …
L3 · Compiler
컴파일러 이론, torch.compile, 커스텀 커널, Legato 등 하드웨어 위의 소프트웨어 스택을 다룹니다.
컴파일러 & 커널torch.compile() 알아보기 - Part 02
torch.compile은 왜 Dynamo, AOTAutograd, Inductor 세 단계로 나뉘어 있을까요? PyTorch가 생태계를 키워 온 흐름에서 출발해, 각 단계의 출력을 누가 어떻게 활 …
컴파일러 & 커널모나드와 범주론 - Part 01
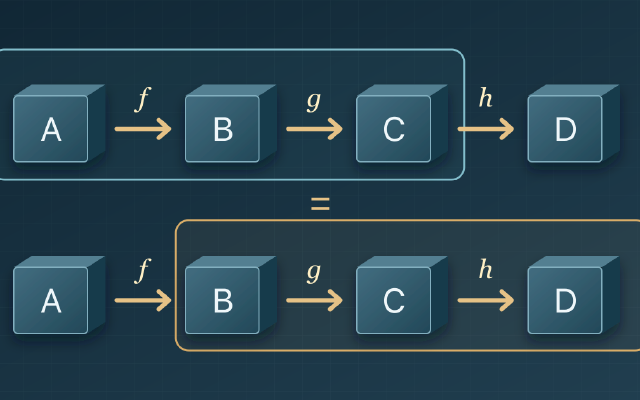
Option을 반환하는 함수들의 타입이 맞지 않아 합성이 끊기는 장면에서 출발해, 조건 분기·map·join·bind가 같은 계산을 만드는 과정을 살펴봅니다.
컴파일러 & 커널torch.compile() 알아보기 - Part 01
torch.compile을 TorchDynamo, AOTAutograd, TorchInductor 세 요소로 분해해, 각각이 무엇을 입력받아 무엇을 내놓고 어떤 원리로 동작하는지 정리합니다.
컴파일러 & 커널Legato - Part 01
LPU를 위한 HyperAccel의 프로그래밍 모델이자 컴파일러 스택인 Legato를 소개하며, 이것이 무엇이고 왜 존재하며 어떻게 설계되었는지 다룹니다.
컴파일러 & 커널
AMD GPU의 inference 성능을 끌어올린 AITER(AI Tensor Engine for ROCm)를 분석합니다.
컴파일러 & 커널지피지기 - 번외편
TPU에서 커스텀 커널을 작성할 수 있게 해주는 Pallas 프로그래밍 모델에 대해 알아봅니다.
컴파일러 & 커널Crafting Compilers - Part 03
오늘은 조금은 색다른 주제를 가지고 왔습니다. 컴파일러를 사용하다가, 자동으로 컴파일러가 loop을 변형하여 최적화해주거나, 병렬화를 해 주면 좋겠다고 생각한 적이 있지 않은가요? 컴파일러 엔지니어 …
컴파일러 & 커널Crafting Compilers - Part 02
컴파일러를 만들기 전에, 우리는 먼저 언어를 정의해야 합니다. 프로그래밍 언어는 단순히 구문으로 정의되는 것이 아닙니다. 사실 프로그래밍 언어는 인간과 컴퓨터 사이의 사용자 인터페이스입니다. 프로그 …
컴파일러 & 커널Crafting Compilers - Part 01
Compilers 이 포스팅 및 앞으로 쓰게 될 시리즈는 compiler가 무엇인지, 어떻게 만들어지는지, 그리고 직접 compiler를 만드는 방법을 설명하는 시리즈가 될 것입니다. …
L2 · Memory
HBM, HBF, CXL, KV 캐시 스토리지 등 AI 시대의 메모리 계층을 다룹니다.
메모리 & 스토리지Ceph 뜯어먹기 - Part 01
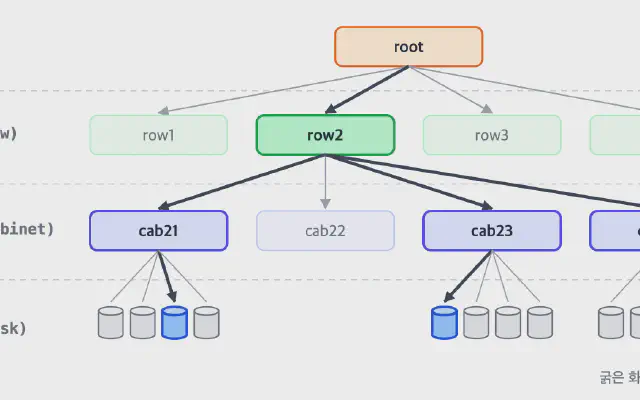
Ceph의 근간인 데이터 분산 알고리즘 CRUSH를 SC'06 논문을 바탕으로 정리합니다. Mapping Table 없이 Object 위치를 계산하는 원리, Placement Rule과 …
메모리 & 스토리지메모리 이해하기 - Part 05
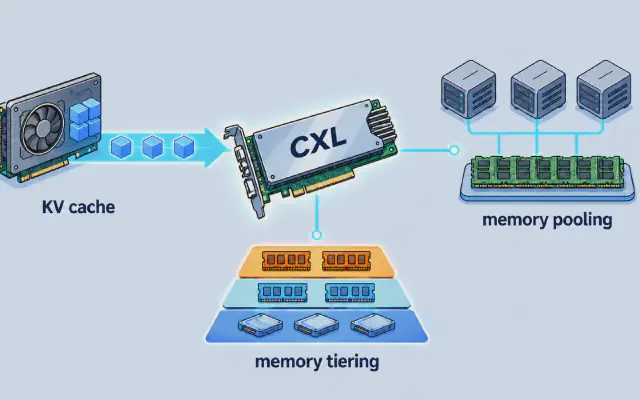
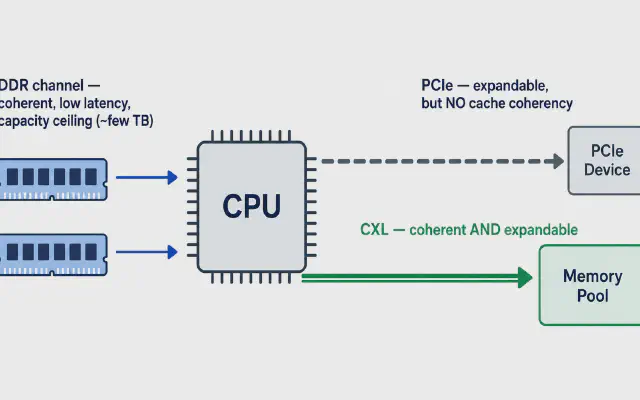
KV cache offload, 메모리 풀링, 메모리 tiering을 통해 CXL이 실제 워크로드에서 어떻게 쓰이는지 살펴봅니다.
메모리 & 스토리지메모리 이해하기 - Part 04
GPU 옆은 HBM과 HBF가 채우지만, CPU 옆에는 또 다른 빈 자리가 있습니다. PCIe와 DDR 사이의 어색한 틈을 메우는 새로운 인터페이스, CXL의 기본 구조와 디바이스 타입, 그리고 메 …
메모리 & 스토리지메모리 이해하기 - Part 03
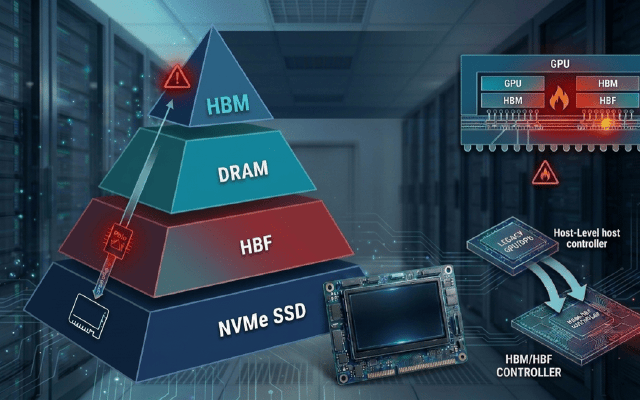
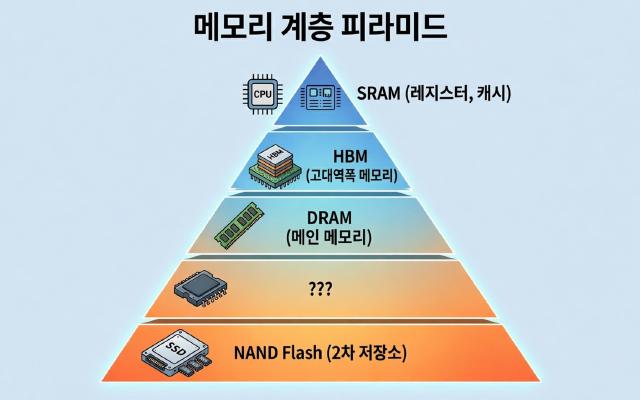
HBF에게 적합한 자리는 분명히 있습니다. 하지만 memory hierarchy 피라미드에 들어가기 위해서는 아직 부족한 점이 많습니다. 최신 LLM 모델 및 추론 워크로드 트렌드, 그리고 …
메모리 & 스토리지메모리 이해하기 - Part 02
SK하이닉스의 H³ 아키텍처를 중심으로, HBF의 약점을 극복할 수 있는 워크로드를 탐색합니다.
메모리 & 스토리지메모리 이해하기 - Part 01
메모리는 왜 여러 종류이고, HBF는 어디에 위치하는가? SRAM부터 HBF까지, 메모리 계층의 물리적 원리와 HBF의 기술 구조를 알아봅니다.
메모리 & 스토리지지피지기 - Part 04
LLM의 새로운 병목인 KV 캐시 용량 문제를 해결하기 위해 NVIDIA가 제시한 새로운 계층의 스토리지인 ICMS와 이를 관리하는 Bluefield-4 DPU의 기술적 원리를 살펴봅니다.
L1 · Hardware
GPU, TPU, LPU, 웨이퍼 스케일 칩부터 CPU까지, AI 가속기 아키텍처를 분석합니다.
AI 반도체
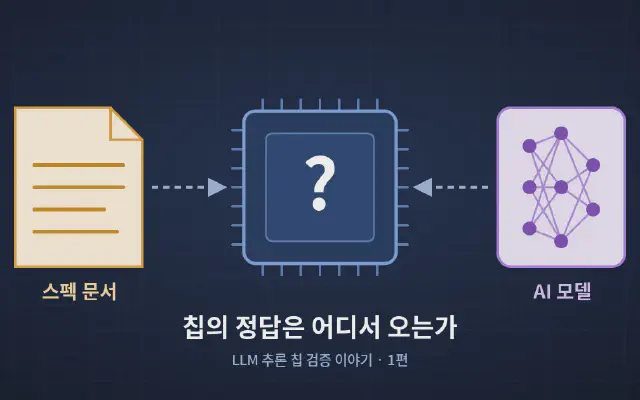
같은 AI 모델을 GPU와 LPU의 RTL에서 돌린 답이 다를 때 누가 틀린 걸까요? LLM 추론 칩 검증에서 정답이 레벨마다 어디서 오는지, 그리고 비교 축을 어떻게 나눠야 책임 소재가 드러나는지 …
AI 반도체지피지기 - Part 07
AI로 AI를 돌리는 칩을 만드는 시대가 도래했습니다. AI 회사인 OpenAI의 자체칩 할라피뇨의 공개된 정보들을 바탕으로 이를 알아봅니다.
AI 반도체지피지기 - Part 06
Agentic AI 워크로드에서 CPU가 추론 인프라의 병목이 된 원인을 분석하고 CPU 3사의 최신 데이터센터향 CPU 라인업을 분석해보며 Agentic AI 시대에 다시 떠오른 CPU의 중요성에 …
AI 반도체지피지기 - Part 05
OpenAI와의 대형 계약 보도로 주목받은 Cerebras의 최근 근황과 WSE-3 아키텍처, 웨이퍼 스케일 칩의 장단점을 비전공자도 이해할 수 있게 정리합니다.
AI 반도체지피지기 - Part 03
그록과 LPU의 탄생 배경과 그들의 하드웨어 / 소프트웨어 설계 철학에 대해 알아보고 엔비디아가 그록을 인수한 의도에 대해 분석해봅니다.
AI 반도체지피지기 - Part 02
TPU의 등장 배경에 대해 알아보고 하드웨어/소프트웨어 구조를 파헤쳐보면서 구글의 AI 반도체 전략에 대해 분석해봅니다.
AI 반도체지피지기 - Part 01
NVIDIA GPU의 역사와 Hopper 아키텍처를 통해, 어떻게 GPU가 메모리 레이턴시를 숨기는지 정리한 글입니다.
메모리 & 스토리지Ceph 뜯어먹기 - Part 01
Ceph의 근간인 데이터 분산 알고리즘 CRUSH를 SC'06 논문을 바탕으로 정리합니다. Mapping Table 없이 Object 위치를 계산하는 원리, Placement Rule과 …
AI 반도체
같은 AI 모델을 GPU와 LPU의 RTL에서 돌린 답이 다를 때 누가 틀린 걸까요? LLM 추론 칩 검증에서 정답이 레벨마다 어디서 오는지, 그리고 비교 축을 어떻게 나눠야 책임 소재가 드러나는지 …
Programming Language
Option과 List의 합성에서 공통된 형태를 발견하고, 합성의 법칙을 증명하며 범주라는 구조를 이해합니다.
Ceph의 근간인 데이터 분산 알고리즘 CRUSH를 SC'06 논문을 바탕으로 정리합니다. Mapping Table 없이 Object 위치를 계산하는 원리, Placement …
같은 AI 모델을 GPU와 LPU의 RTL에서 돌린 답이 다를 때 누가 틀린 걸까요? LLM 추론 칩 검증에서 정답이 레벨마다 어디서 오는지, 그리고 비교 축을 어떻게 나눠야 책임 …
Option을 반환하는 함수들의 타입이 맞지 않아 합성이 끊기는 장면에서 출발해, 조건 분기·map·join·bind가 같은 계산을 만드는 과정을 살펴봅니다.
torch.compile을 TorchDynamo, AOTAutograd, TorchInductor 세 요소로 분해해, 각각이 무엇을 입력받아 무엇을 내놓고 어떤 원리로 동작하는지 …
메모리는 왜 여러 종류이고, HBF는 어디에 위치하는가? SRAM부터 HBF까지, 메모리 계층의 물리적 원리와 HBF의 기술 구조를 알아봅니다.
안녕하세요, 하이퍼엑셀 ML 팀 엔지니어 엄태서입니다. 개발자들 사이에는 이런 농담이 있습니다. “우리 일은 결국 문제를 구글에 검색하고, 첫 번째로 뜨는 링크를 눌러서, …
안녕하세요! 저는 HyperAccel ML팀에서 DevOps Engineer로 근무하고 있는 전영훈입니다. 이 글을 보시는 분들 중에서 개발자 여러분들은 어떤 환경에서 개발하고 계 …
Compilers 이 포스팅 및 앞으로 쓰게 될 시리즈는 compiler가 무엇인지, 어떻게 만들어지는지, 그리고 직접 compiler를 만드는 방법을 설명하는 시리즈가 될 것입니 …
GPU, TPU, LPU, 웨이퍼 스케일 칩부터 CPU까지, AI 가속기 아키텍처를 분석합니다.
AI 반도체
AI 반도체지피지기 - Part 07
AI 반도체지피지기 - Part 06
AI 반도체지피지기 - Part 05
AI 반도체지피지기 - Part 03
AI 반도체지피지기 - Part 02
AI 반도체지피지기 - Part 01
HBM, HBF, CXL, KV 캐시 스토리지 등 AI 시대의 메모리 계층을 다룹니다.
메모리 & 스토리지Ceph 뜯어먹기 - Part 01
메모리 & 스토리지메모리 이해하기 - Part 05
메모리 & 스토리지메모리 이해하기 - Part 04
메모리 & 스토리지메모리 이해하기 - Part 03
메모리 & 스토리지메모리 이해하기 - Part 02
메모리 & 스토리지메모리 이해하기 - Part 01
메모리 & 스토리지지피지기 - Part 04
컴파일러 이론, torch.compile, 커스텀 커널, Legato 등 하드웨어 위의 소프트웨어 스택을 다룹니다.
컴파일러 & 커널torch.compile() 알아보기 - Part 02
컴파일러 & 커널모나드와 범주론 - Part 01
컴파일러 & 커널torch.compile() 알아보기 - Part 01
컴파일러 & 커널Legato - Part 01
컴파일러 & 커널
컴파일러 & 커널지피지기 - 번외편
컴파일러 & 커널Crafting Compilers - Part 03
컴파일러 & 커널Crafting Compilers - Part 02
컴파일러 & 커널Crafting Compilers - Part 01
Transformer 구조, 서빙 프레임워크, 최신 모델 분석을 다룹니다.
LLM & 모델
LLM & 모델
LLM & 모델
Kubernetes 기반 개발 환경, CI/CD, 디바이스 플러그인 등 HyperAccel의 인프라 구축기입니다.
인프라 & DevOpsK8s 개발 환경 구축기 - Part 03
인프라 & DevOpsK8s 개발 환경 구축기 - Part 02
인프라 & DevOpsK8s 개발 환경 구축기 - Part 01
AI 코딩 에이전트, 개발 방법론, 기술 블로그 운영 등 일하는 방식에 대한 이야기입니다.
개발 문화 & AI 도구AI Agent - Part 02
개발 문화 & AI 도구AI Agent - Part 01
개발 문화 & AI 도구
개발 문화 & AI 도구
CES, NAVER DAN, PyTorch Conference 등 참관기입니다.
컨퍼런스 리포트
컨퍼런스 리포트
컨퍼런스 리포트
Programming Language